En entreprise, un prototype issu du vibe coding, cette façon de produire une application en la décrivant en langage courant à un outil d’intelligence artificielle (IA) qui en écrit le code, prouve qu’un parcours tient debout, pas qu’un outil peut tourner chez vous : il ne couvre pas tous les cas d’usage et ignore la vision du produit à long terme. Il devient la meilleure des spécifications, à condition de reconstruire ses fondations avant de le confier à vos équipes. Nous utilisons nous-mêmes ces outils pour prototyper vite, et c’est en les utilisant que nous avons appris où passe la frontière entre une démonstration et un outil en service.
Des générateurs d’applications comme Lovable, Claude Design, Bolt ou v0 rendent le vibe coding accessible à une personne qui n’a jamais programmé. En 2026, ces outils sont à la portée de toutes les petites et moyennes entreprises (PME), et un prototype interne peut se mettre à servir au quotidien sans que personne ait relu son code.
Ce que le vibe coding fait très bien en entreprise
Le vibe coding rend tangible en quelques heures une idée qui tenait jusque-là dans un mail ou un tableur. Une responsable d’exploitation peut montrer à sa direction l’écran de saisie qu’elle attend, avec ses vrais champs et ses vrais statuts, au lieu de le décrire en réunion.
Ce prototype fait réagir. Les futurs utilisateurs pointent ce qui manque, ce qui est de trop, l’étape qu’ils feraient dans un autre ordre. Ces réactions valent plus qu’un cahier des charges de trente pages, parce qu’elles portent sur un objet que les gens ont eu entre les mains.
Un prototype sert à décider, quelle que soit la façon dont il a été produit. Pour un groupe de protection sociale, nous avons conçu en atelier, sans générateur d’applications, un prototype interactif de simulateur en 4 jours. Testé auprès d’utilisateurs, il a permis de trancher avant d’engager le développement et d’économiser 6 mois de développement. Ce prototype n’a jamais été mis en service : il a servi à savoir quoi construire.
Pourquoi un prototype généré n’est pas un outil en service
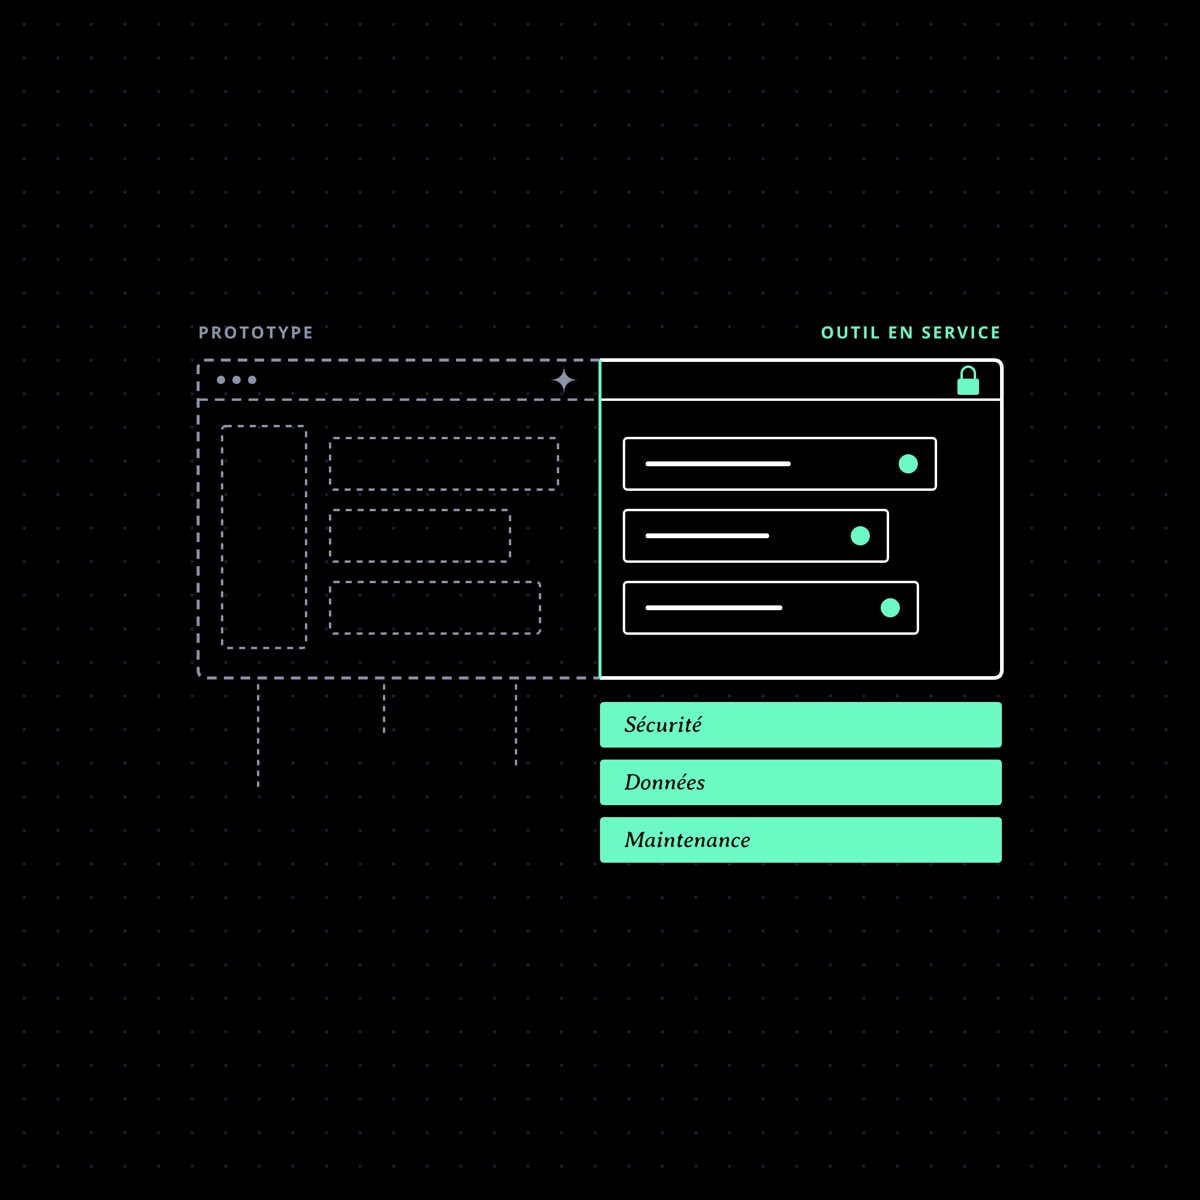
Un prototype généré est construit pour fonctionner devant vous, une fois, avec des données d’exemple. Un outil en service doit tenir face à une équipe entière, à des données réelles et à des personnes mal intentionnées, tous les jours, pendant des années.
| Question | Dans un prototype généré | Dans un outil en service |
|---|---|---|
| Qui peut se connecter | Souvent tout le monde, ou un mot de passe partagé | Des comptes individuels, des droits par rôle, les départs gérés |
| Où vont les données | Dans la base créée par défaut, hébergée là où l’outil l’a décidé | Chez un hébergeur choisi, sauvegardées, conformes au RGPD (règlement général sur la protection des données) |
| Les clés d’accès aux autres logiciels | Parfois écrites dans le code que le navigateur affiche | Gardées sur le serveur, jamais visibles par l’utilisateur |
| Les cas imprévus | Le cas prévu fonctionne | Saisie incomplète, doublons, panne d’un service connecté : chaque cas a une réponse |
| Qui corrige demain | La personne qui a écrit la consigne, si elle s’en souvient | Toute équipe technique, grâce à la documentation |
| Les évolutions | Chaque demande régénère une partie du code | Un ajout ciblé, testé, qui ne casse pas l’existant |
Un risque passe facilement inaperçu. Pour qu’un prototype lise votre CRM (le logiciel de gestion de la relation client) ou votre messagerie, le générateur y place une clé d’accès. Si le prototype est mis en ligne tel quel, cette clé peut se retrouver lisible par n’importe quel visiteur. Personne n’a fauté : le prototype fait ce qui lui a été demandé, et rien de plus.
Le prototype ne se jette pas, il se reconstruit
Un prototype validé par vos équipes est la meilleure spécification possible : nous le reconstruisons sur une base saine plutôt que de corriger son code morceau par morceau.
Corriger un code généré coûte souvent plus cher que le réécrire. Sa structure n’a pas été pensée pour durer : les mêmes règles sont répétées à plusieurs endroits, et chaque correction en déplace une autre. Le prototype porte en revanche tout ce qui compte pour la suite : le parcours, les écrans, les champs, les règles métier et les réactions des utilisateurs qui l’ont testé.
La reconstruction garde tout cela et ajoute ce que le prototype laisse de côté : les fondations techniques, une description fonctionnelle complète avec les cas limites et tous les états des écrans (vide, en erreur, en chargement), la structure de la base de données et la sécurité des données. Pour vos équipes, l’outil final ressemble au prototype qu’elles ont validé. Il tient simplement face à l’usage quotidien de toute une équipe.
Les cinq étapes entre le prototype et l’outil en service
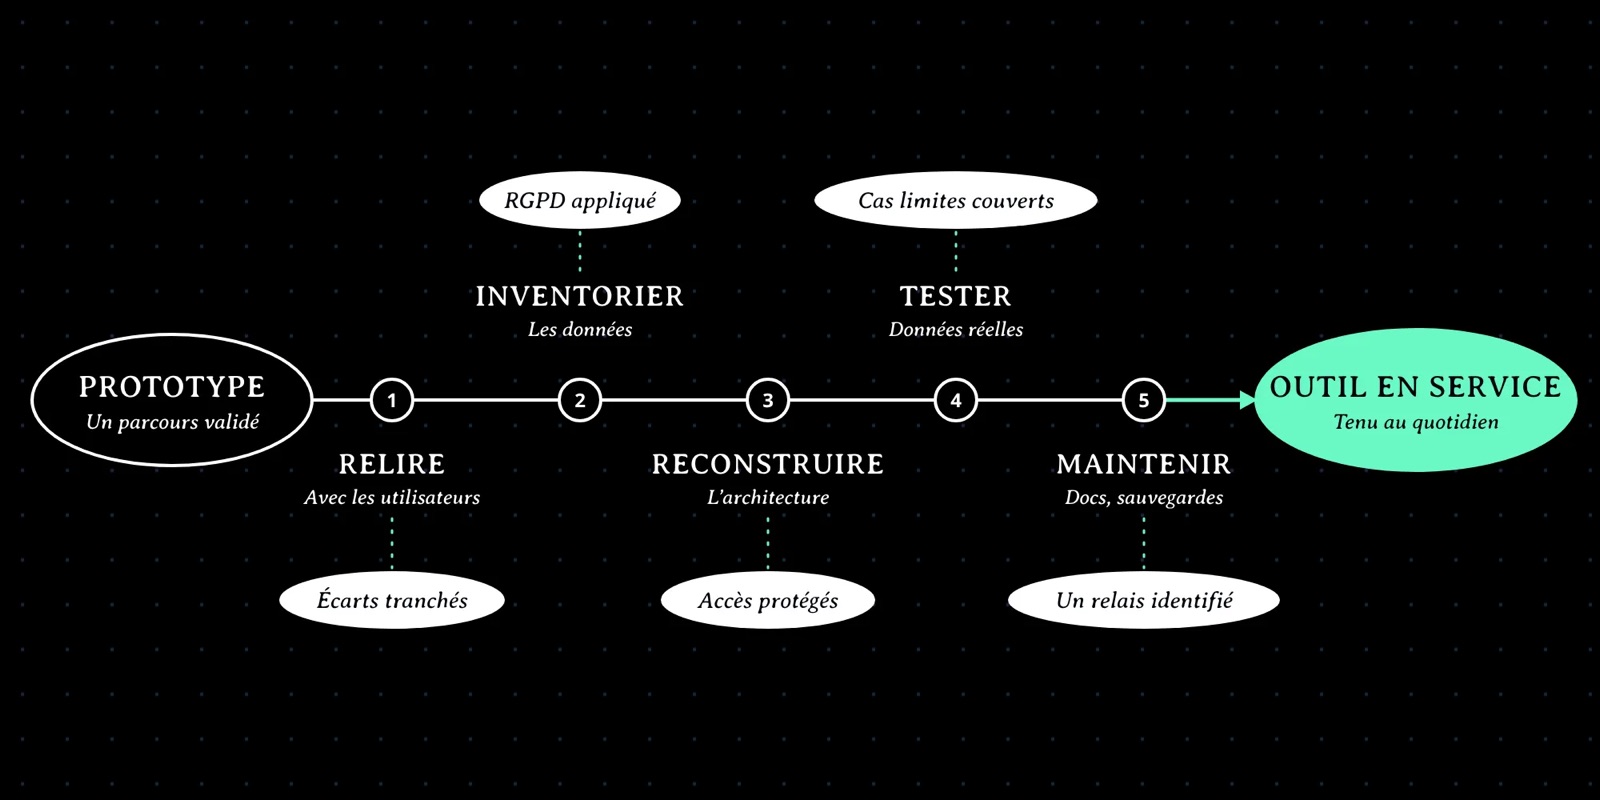
Le passage se fait en cinq étapes, dans cet ordre, et la première commence avant toute ligne de code.
- Relire le prototype avec ceux qui l’utiliseront. Nous listons ce qui a été testé, ce qui ne l’a pas été, et les contournements que les utilisateurs ont déjà imaginés. Un référent métier, une personne de votre équipe qui connaît le travail réel, tranche les écarts.
- Inventorier les données. Quelles données entrent dans l’outil, d’où elles viennent, qui peut les lire, combien de temps elles restent. Dès qu’une donnée personnelle apparaît, le RGPD s’applique.
- Reconstruire sur une architecture choisie. Hébergement, connexion des utilisateurs, droits par rôle, clés d’accès gardées sur le serveur. Les écrans du prototype servent de référence visuelle et fonctionnelle.
- Tester avec des données réelles et des cas limites. Une saisie incomplète, deux personnes sur la même fiche, un logiciel connecté qui ne répond plus : chaque cas est essayé avant la mise en service.
- Organiser la maintenance. Documentation, sauvegardes, mises à jour de sécurité, et une personne identifiée qui sait intervenir quand quelque chose casse.