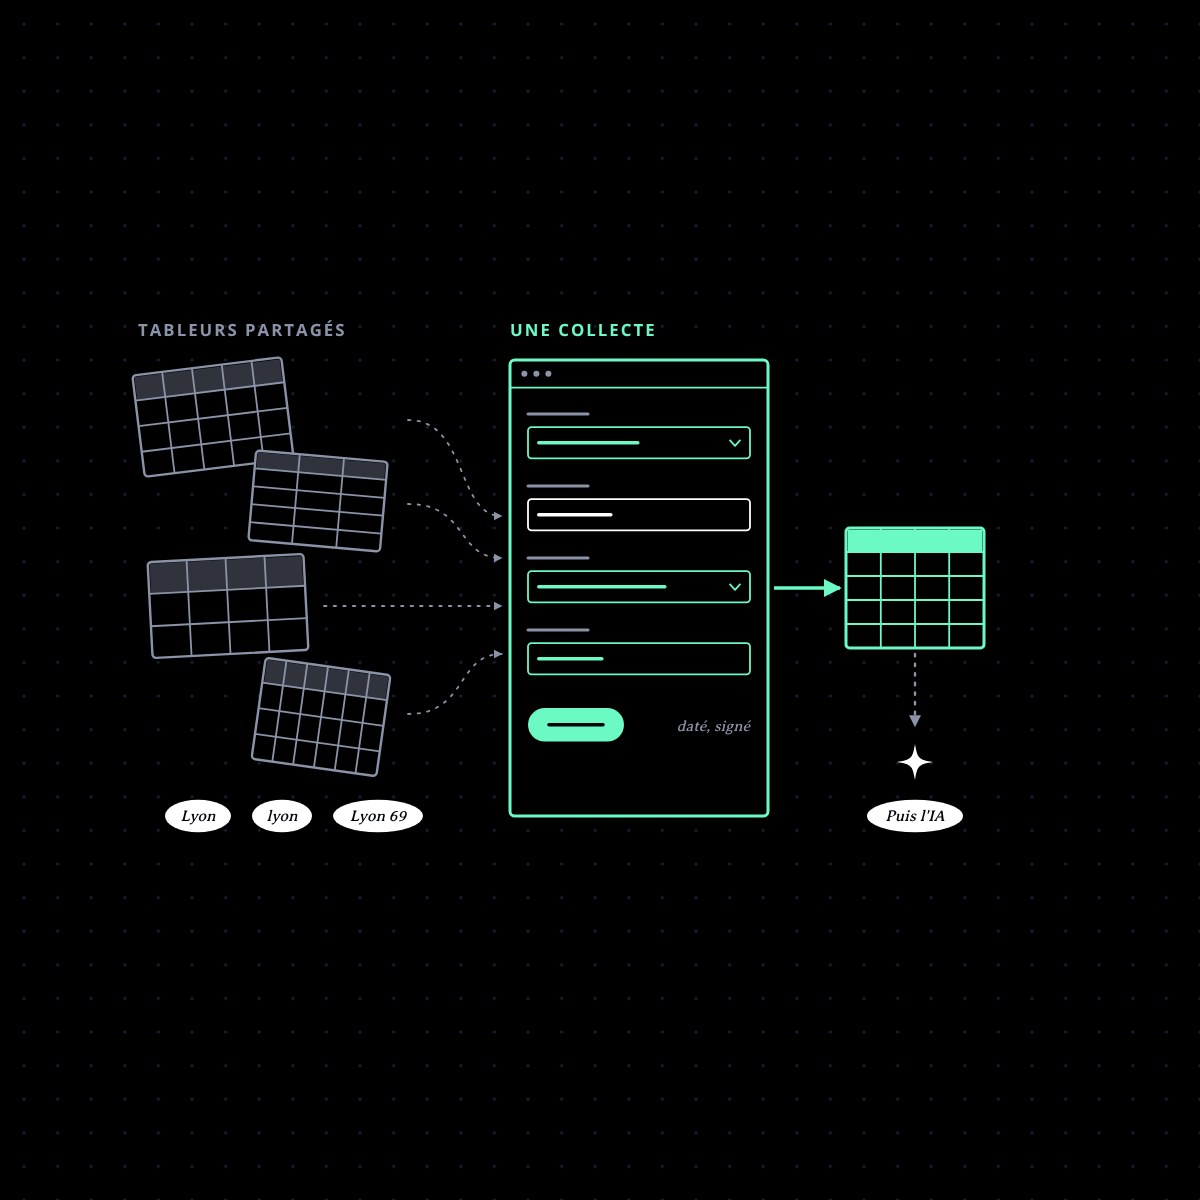
Préparer ses données pour l’intelligence artificielle (IA), c’est d’abord fiabiliser la façon dont elles sont saisies, avant de choisir un modèle ou un outil. Dans les projets que nous cadrons, un usage d’IA bute plus souvent sur des informations dispersées dans des tableurs partagés que sur le choix du modèle. Nous commençons donc par l’outil de collecte du quotidien, celui qui remplace le tableur : une fois les données saisies au même format et au même endroit, le bon cas d’usage devient visible, et le projet d’IA n’a plus à financer une reprise des données en cours de route.
L’erreur fréquente : choisir l’outil avant de regarder les données
L’erreur consiste à comparer des outils d’IA alors que les données qu’ils devront lire ne sont pas encore exploitables.
Une scène revient souvent en atelier de cadrage. Une direction commerciale veut un assistant qui résume l’état des offres en cours. Les informations vivent dans un tableur partagé, tenu par région. Chaque équipe y a ajouté ses colonnes, une ligne correspond tantôt à un devis, tantôt à un client, et l’information décisive se trouve dans une cellule « commentaire » écrite en texte libre.
Branché sur ce fichier, un grand modèle de langage (LLM), le type de modèle qui fait fonctionner les assistants conversationnels, produit des réponses banales, ou fausses avec assurance. Le modèle n’est pas en cause : il lit fidèlement un fichier qui se contredit.
Pourquoi un tableur partagé produit des données inexploitables
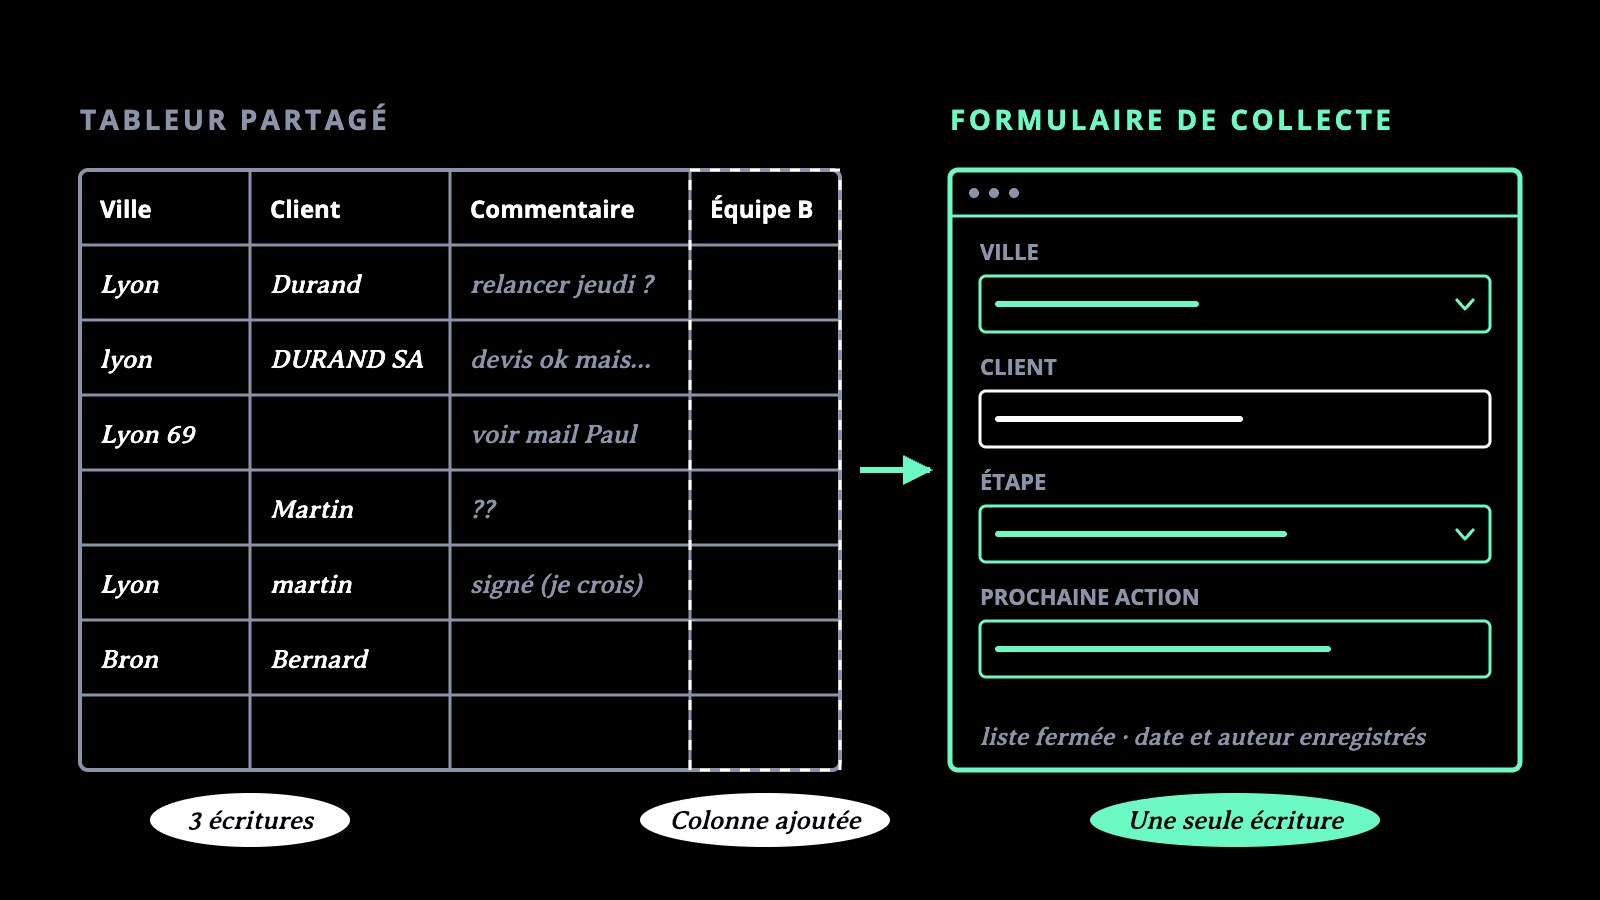
Un tableur partagé n’impose rien au moment de la saisie : chaque contributeur écrit l’information à sa façon, et ces écarts s’accumulent. Un humain les corrige de tête en lisant ; une IA les prend au pied de la lettre.
| Ce que nous trouvons dans le tableur | Ce qu’une IA en fait | Ce qu’un outil de collecte impose |
|---|
| La même valeur écrite de trois façons (« Lyon », « lyon », « Lyon 69 ») | Trois valeurs distinctes | Une liste fermée de choix |
| L’information utile dans une cellule de commentaire | Une interprétation au hasard | Un champ dédié, obligatoire si besoin |
| Des colonnes ajoutées par une seule équipe | Une structure qui change d’une ligne à l’autre | Un modèle de données unique |
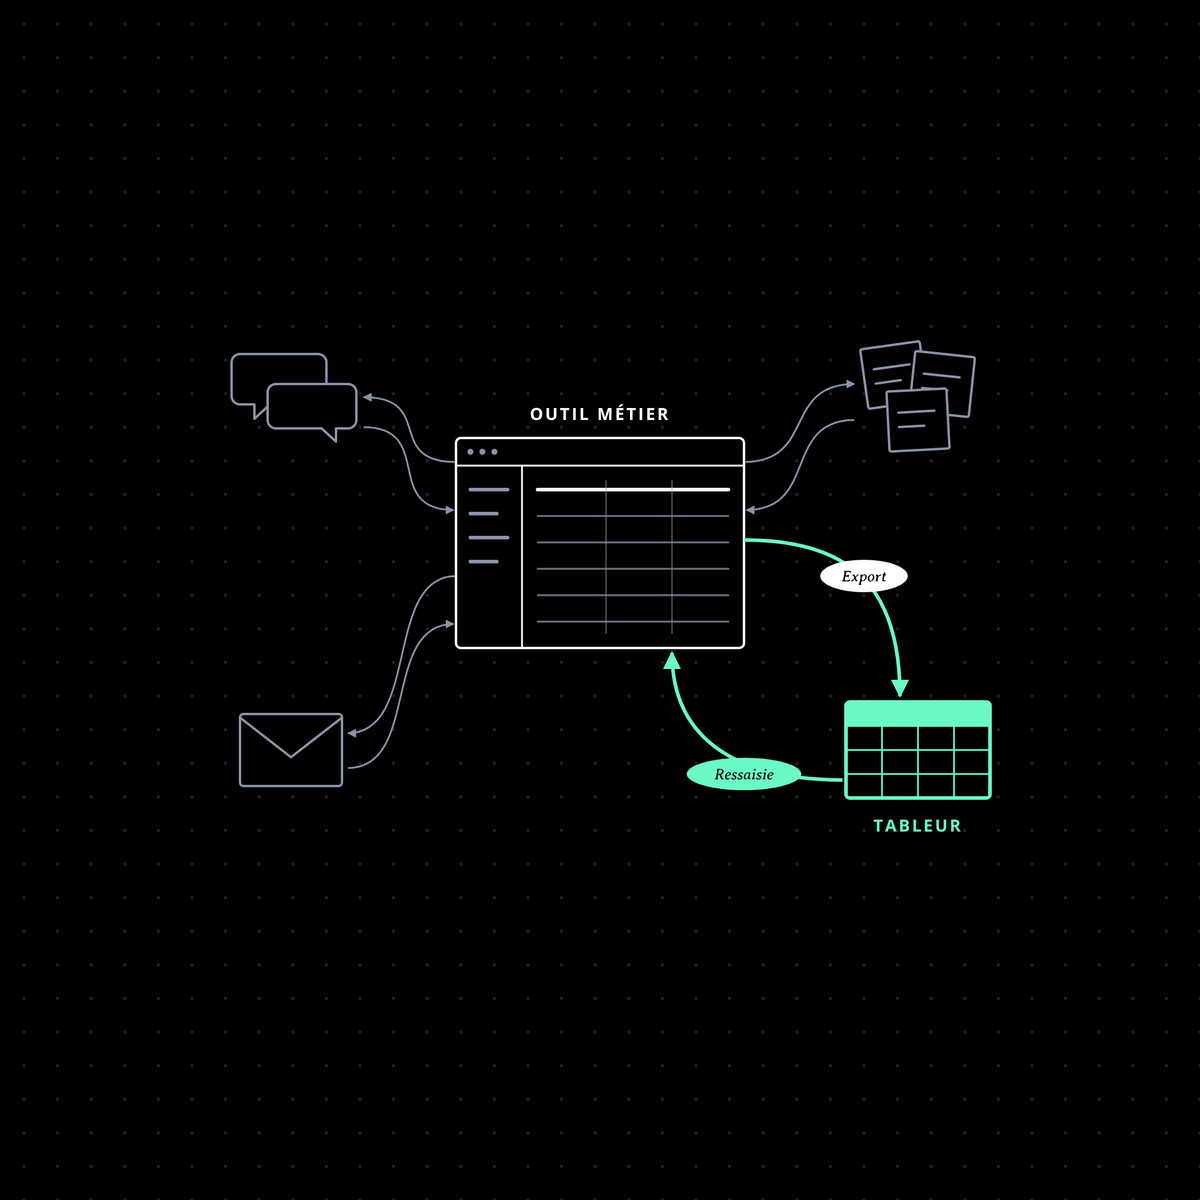
| Une copie locale renvoyée par mail | Deux versions présentées comme vraies | Une seule source, avec un historique |
| Aucune date de saisie | Aucune idée de ce qui est à jour | Une date et un auteur enregistrés automatiquement |
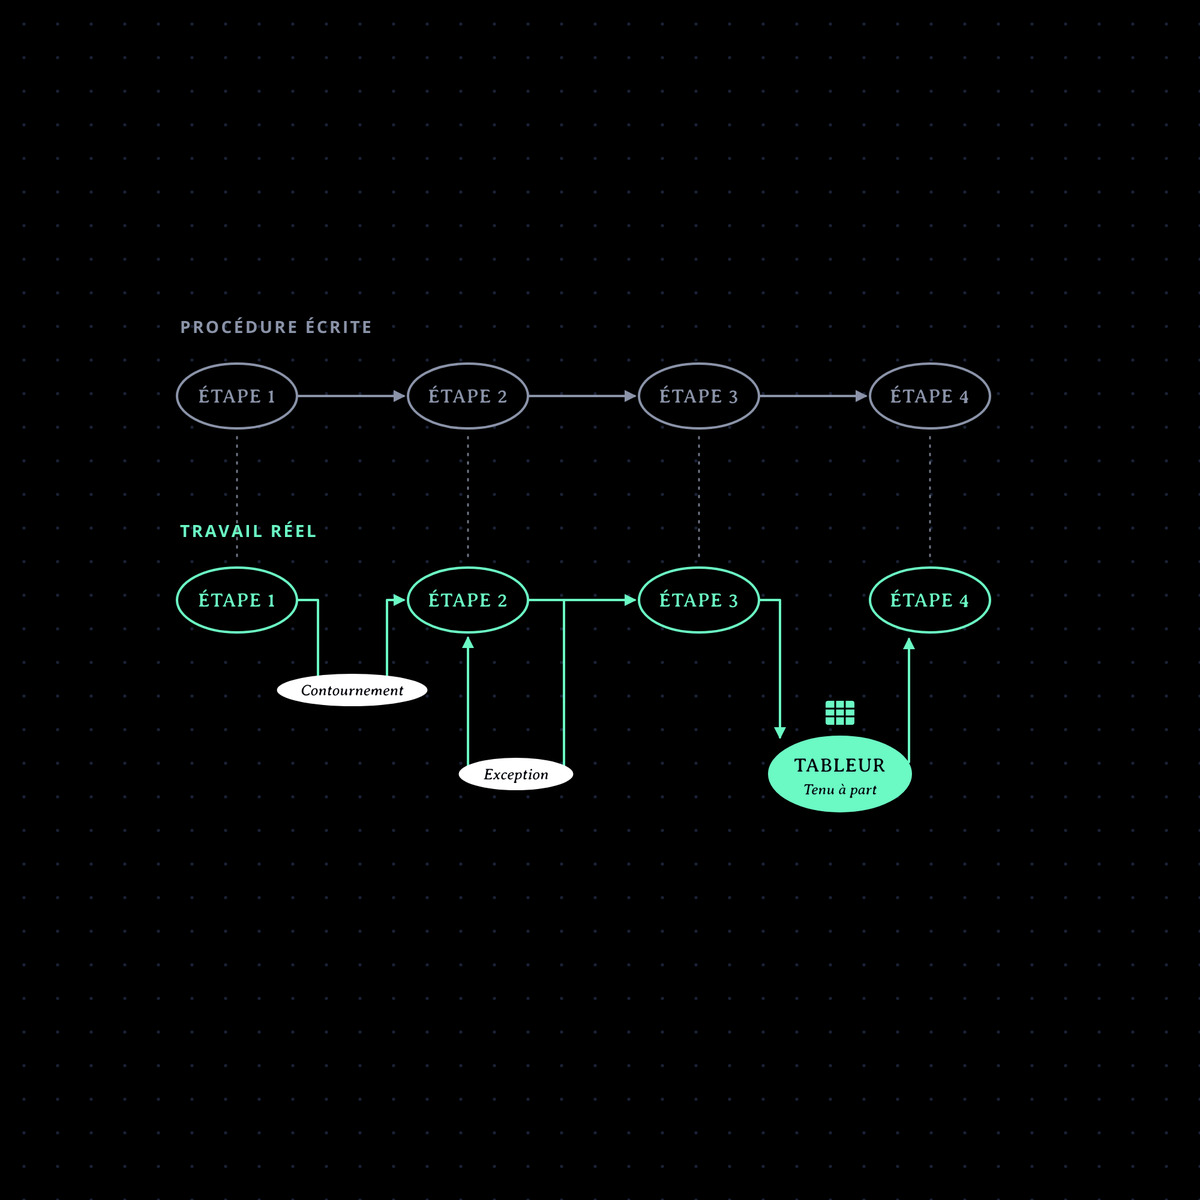
Ces écarts sont rarement des erreurs individuelles. Ce sont des contournements : chaque équipe a adapté le fichier à son travail réel, faute d’un outil prévu pour cela. Nous les lisons comme de la matière de cadrage, selon la méthode décrite dans notre article sur les contournements d’un outil métier.
Nettoyer les données une fois ne suffit pas
Un nettoyage ponctuel produit une base propre à une date donnée, puis le tableur reprend ses habitudes. Quelques mois plus tard, les mêmes écarts sont revenus, parce que rien n’a changé dans la façon de saisir.
Le nettoyage sert à reprendre l’historique quand l’outil de collecte est mis en service. Pour une petite ou moyenne entreprise (PME), les données exploitables dans la durée viennent de l’outil que les équipes utilisent chaque jour, et non d’une opération de reprise menée une fois par an.
Préparer ses données pour l’IA : notre méthode en cinq étapes
Nous partons de la décision à éclairer, puis nous remontons jusqu’à la saisie. La méthode tient en cinq étapes, menées avec les équipes qui produisent la donnée.
- Nommer la décision. Quelle décision doit être prise, par qui, à quelle fréquence ? Une donnée qui ne sert aucune décision n’a pas à être collectée.
- Recenser les sources réelles. Les tableurs, les mails récapitulatifs, les exports d’un logiciel retravaillés à la main : nous listons tout ce qui circule, avec le nombre de personnes qui y contribuent.
- Fixer le modèle de données avec un référent métier. Une personne de l’équipe, qui connaît le travail réel, valide les champs, les listes de valeurs et les cas particuliers.
- Remplacer le tableur partagé par un outil de collecte. Formulaires, listes fermées, droits différents selon les rôles, date et auteur enregistrés à chaque saisie.
- Laisser tourner, puis regarder. Après quelques semaines de saisie propre, nous examinons ce que les données permettent : un tableau de bord, une alerte, ou un usage d’IA.
Un exemple : un fichier partagé par 75 à 100 contributeurs
Pour un acteur international des technologies médicales (MedTech), nous avons remplacé un fichier Excel partagé par 75 à 100 contributeurs par un outil de collecte des informations de prix. La mission portait sur la collecte, pas sur un modèle d’IA.
Les informations de prix arrivent désormais dans un seul outil, avec des droits différents selon les rôles, au lieu de circuler dans un fichier que chacun modifiait. Les contraintes légales du secteur (anonymisation, agrégation, niveau de détail limité) ont été intégrées dès la conception.
Ce cas montre l’ordre que nous défendons : la collecte d’abord, l’IA ensuite si elle sert. Toute analyse future, avec ou sans IA, partira d’une base que personne n’aura à reconstituer.
Parfois, l’IA n’est plus nécessaire
Une fois les données structurées, une partie des questions que vous vouliez poser à une IA trouve sa réponse dans un indicateur bien construit. C’est un résultat fréquent, et nous le disons au cadrage, avant le devis.
Pour un acteur de la maîtrise de l’énergie dans l’industrie, les consommations d’électricité et de gaz remontaient déjà par des capteurs et des interfaces de programmation (API), qui permettent à deux logiciels d’échanger des données. Elles restaient pourtant difficiles à exploiter pour décider. Le travail a d’abord consisté à définir les indicateurs avec les métiers, à partir de données hétérogènes, et à les organiser par site et par ligne de production. Le résultat est un tableau de bord avec ses comparaisons et ses alertes, pensé pour se dupliquer d’un site à l’autre.
Repérer une dérive de consommation ou comparer deux périodes ne demandait pas de modèle de langage. Cela demandait des données rangées et des indicateurs choisis avec les personnes qui décident. Notre page exploiter les données que vous avez déjà détaille cette démarche, du choix des indicateurs au tableau de bord en service.
Ce que des données structurées changent pour un projet d’IA
Quand l’IA reste utile, des données structurées évitent de reprendre les données en cours de projet et rendent le résultat vérifiable. Le modèle lit des champs fiables au lieu de deviner le sens d’une cellule.
Le cas d’usage se choisit sur pièces : nous voyons quelles questions reviennent, sur quel volume, avec quel niveau d’erreur acceptable. Le périmètre de l’assistant se décrit plus facilement, comme nous le détaillons dans notre article sur ce qu’un assistant IA métier ne doit pas faire. Et le résultat se mesure, puisque la donnée d’entrée est connue.
L’outil de collecte reste aussi ce qui vous appartient : le code, les maquettes et la documentation vous appartiennent dès le paiement, sans licence ni redevance. Notre page intégrer l’IA dans votre métier présente les usages que nous construisons sur cette base.
Quand commencer par la collecte n’est pas la bonne approche
Structurer la collecte d’abord n’est pas adapté dans quatre situations.
Quand la donnée est du texte libre par nature. Des mails clients, des contrats ou des comptes rendus ne se transforment pas en formulaire. La préparation porte alors sur le classement des documents et sur les droits d’accès, pas sur la saisie.
Quand le volume est faible. Un tableur tenu par deux personnes, avec quelques dizaines de lignes, se fiabilise avec des listes de validation et une règle d’usage. Construire un outil serait disproportionné.
Quand le process n’est pas stabilisé. Si chaque équipe travaille encore différemment, figer la collecte fige un process qui n’est pas décidé. Il faut d’abord l’arrêter avec les équipes.
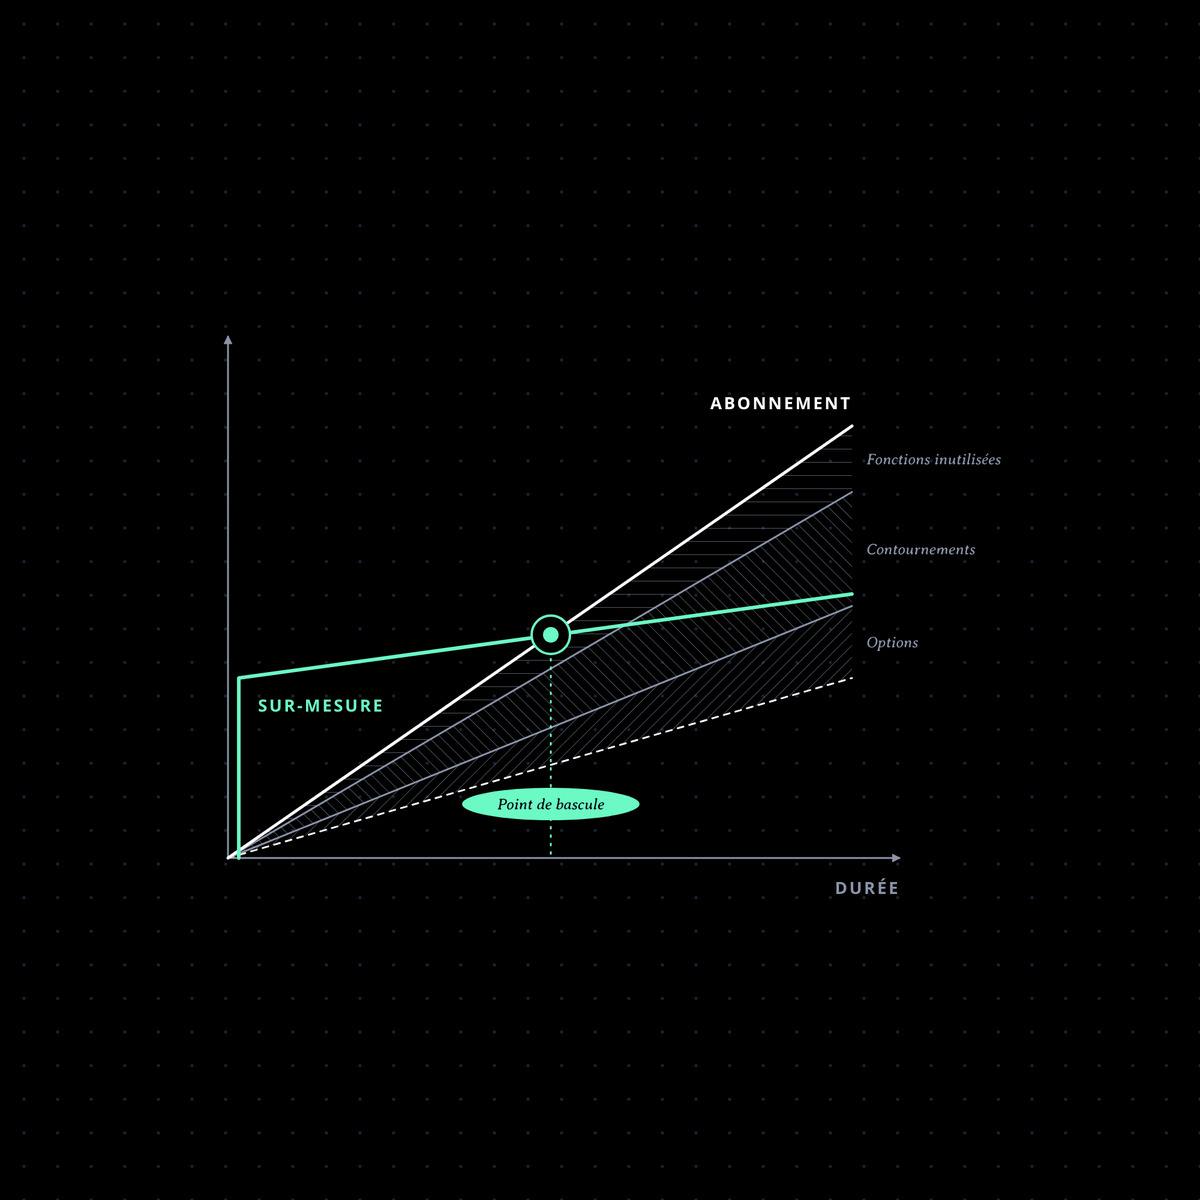
Quand un logiciel du marché couvre déjà la collecte. Un logiciel de gestion de la relation client (CRM) ou un progiciel de gestion intégré (ERP) bien configuré fait souvent le travail. Quand un logiciel du marché couvre l’essentiel de votre besoin, nous vous le disons. Pour arbitrer entre un outil construit pour vous et un logiciel par abonnement (SaaS), notre article sur-mesure ou SaaS détaille les signaux qui font pencher le calcul d’un côté ou de l’autre.
Par où commencer
Commencez par le fichier partagé que votre équipe n’ose plus modifier. C’est presque toujours lui qui porte les données dont un futur projet d’IA aura besoin. Listez qui y contribue et quelle décision il permet de prendre : si le fichier ne suit plus, l’outil de collecte passe avant tout choix de modèle.